



RABBITMQ VÀ APACHE KAFKA
Chọn hệ thống nào cho messaging, queueing và streaming?
Bản viết lại dễ tiếp cận từ bài kỹ thuật chính thức của RabbitMQ
Cập nhật theo bài nguồn phiên bản 4.3 — tháng 09/2026
Tóm tắt nhanh
RabbitMQ và Apache Kafka từng được phân biệt rất đơn giản: RabbitMQ dành cho messaging và task queue, còn Kafka dành cho event streaming. Cách chia này từng hữu ích, nhưng hiện đã lỗi thời. RabbitMQ có Streams — một distributed log thực thụ — còn Kafka có share groups, cho phép xử lý công việc theo kiểu queue.
Điểm quan trọng không phải là hệ thống nào “mạnh hơn” một cách tuyệt đối. Hai hệ thống bắt đầu từ hai đầu khác nhau và đang tiến lại gần nhau, nhưng vẫn giữ những giả định kiến trúc ban đầu. Kafka vẫn đặc biệt mạnh khi cần lưu và phát lại khối lượng lịch sử rất lớn. RabbitMQ vẫn nổi bật khi cần định tuyến linh hoạt và xử lý từng message như một đơn vị công việc độc lập.
Khuyến nghị thực tế của bài nguồn là: bắt đầu với RabbitMQ, sau đó bổ sung Kafka khi bạn gặp một yêu cầu mà chỉ Kafka đáp ứng tốt, chẳng hạn log compaction, tiered storage hoặc thư viện Kafka Streams.
1. Trước hết, hãy bỏ cách nghĩ “queue đối đầu với log”
Một queue thường phục vụ việc phân phối công việc. Một message được giao cho một consumer, được xác nhận rồi biến mất khỏi backlog. Ngược lại, một log giữ lại chuỗi sự kiện theo thứ tự. Consumer đọc từ một vị trí, được gọi là offset, và có thể quay lại đọc lịch sử.
RabbitMQ đã có Streams từ phiên bản 3.9. Stream là append-only log được lưu trên đĩa, có replication, retention, offset và giao thức riêng cho throughput cao. Super streams cho phép chia một stream logic thành nhiều stream để xử lý song song mà vẫn giữ thứ tự trong từng phân vùng.
Kafka 4.2 cũng đã có share groups. Một nhóm consumer có thể nhận từng message, xác nhận riêng lẻ, retry và có nhiều consumer hơn số partition. Vì vậy, cách mô tả công bằng hơn hiện nay là: cả hai đều hỗ trợ log và queue, nhưng queue của Kafka là semantics được xây trên log, còn RabbitMQ có queue và log như hai kiểu cấu trúc dữ liệu riêng.
2. RabbitMQ tổ chức dữ liệu như thế nào?
RabbitMQ tách việc định tuyến khỏi nơi lưu message. Publisher gửi message vào exchange. Binding là các quy tắc gắn với exchange, quyết định message được sao chép tới queue hoặc stream nào. Sau exchange, người vận hành chọn loại queue phù hợp với tính chất của workload.
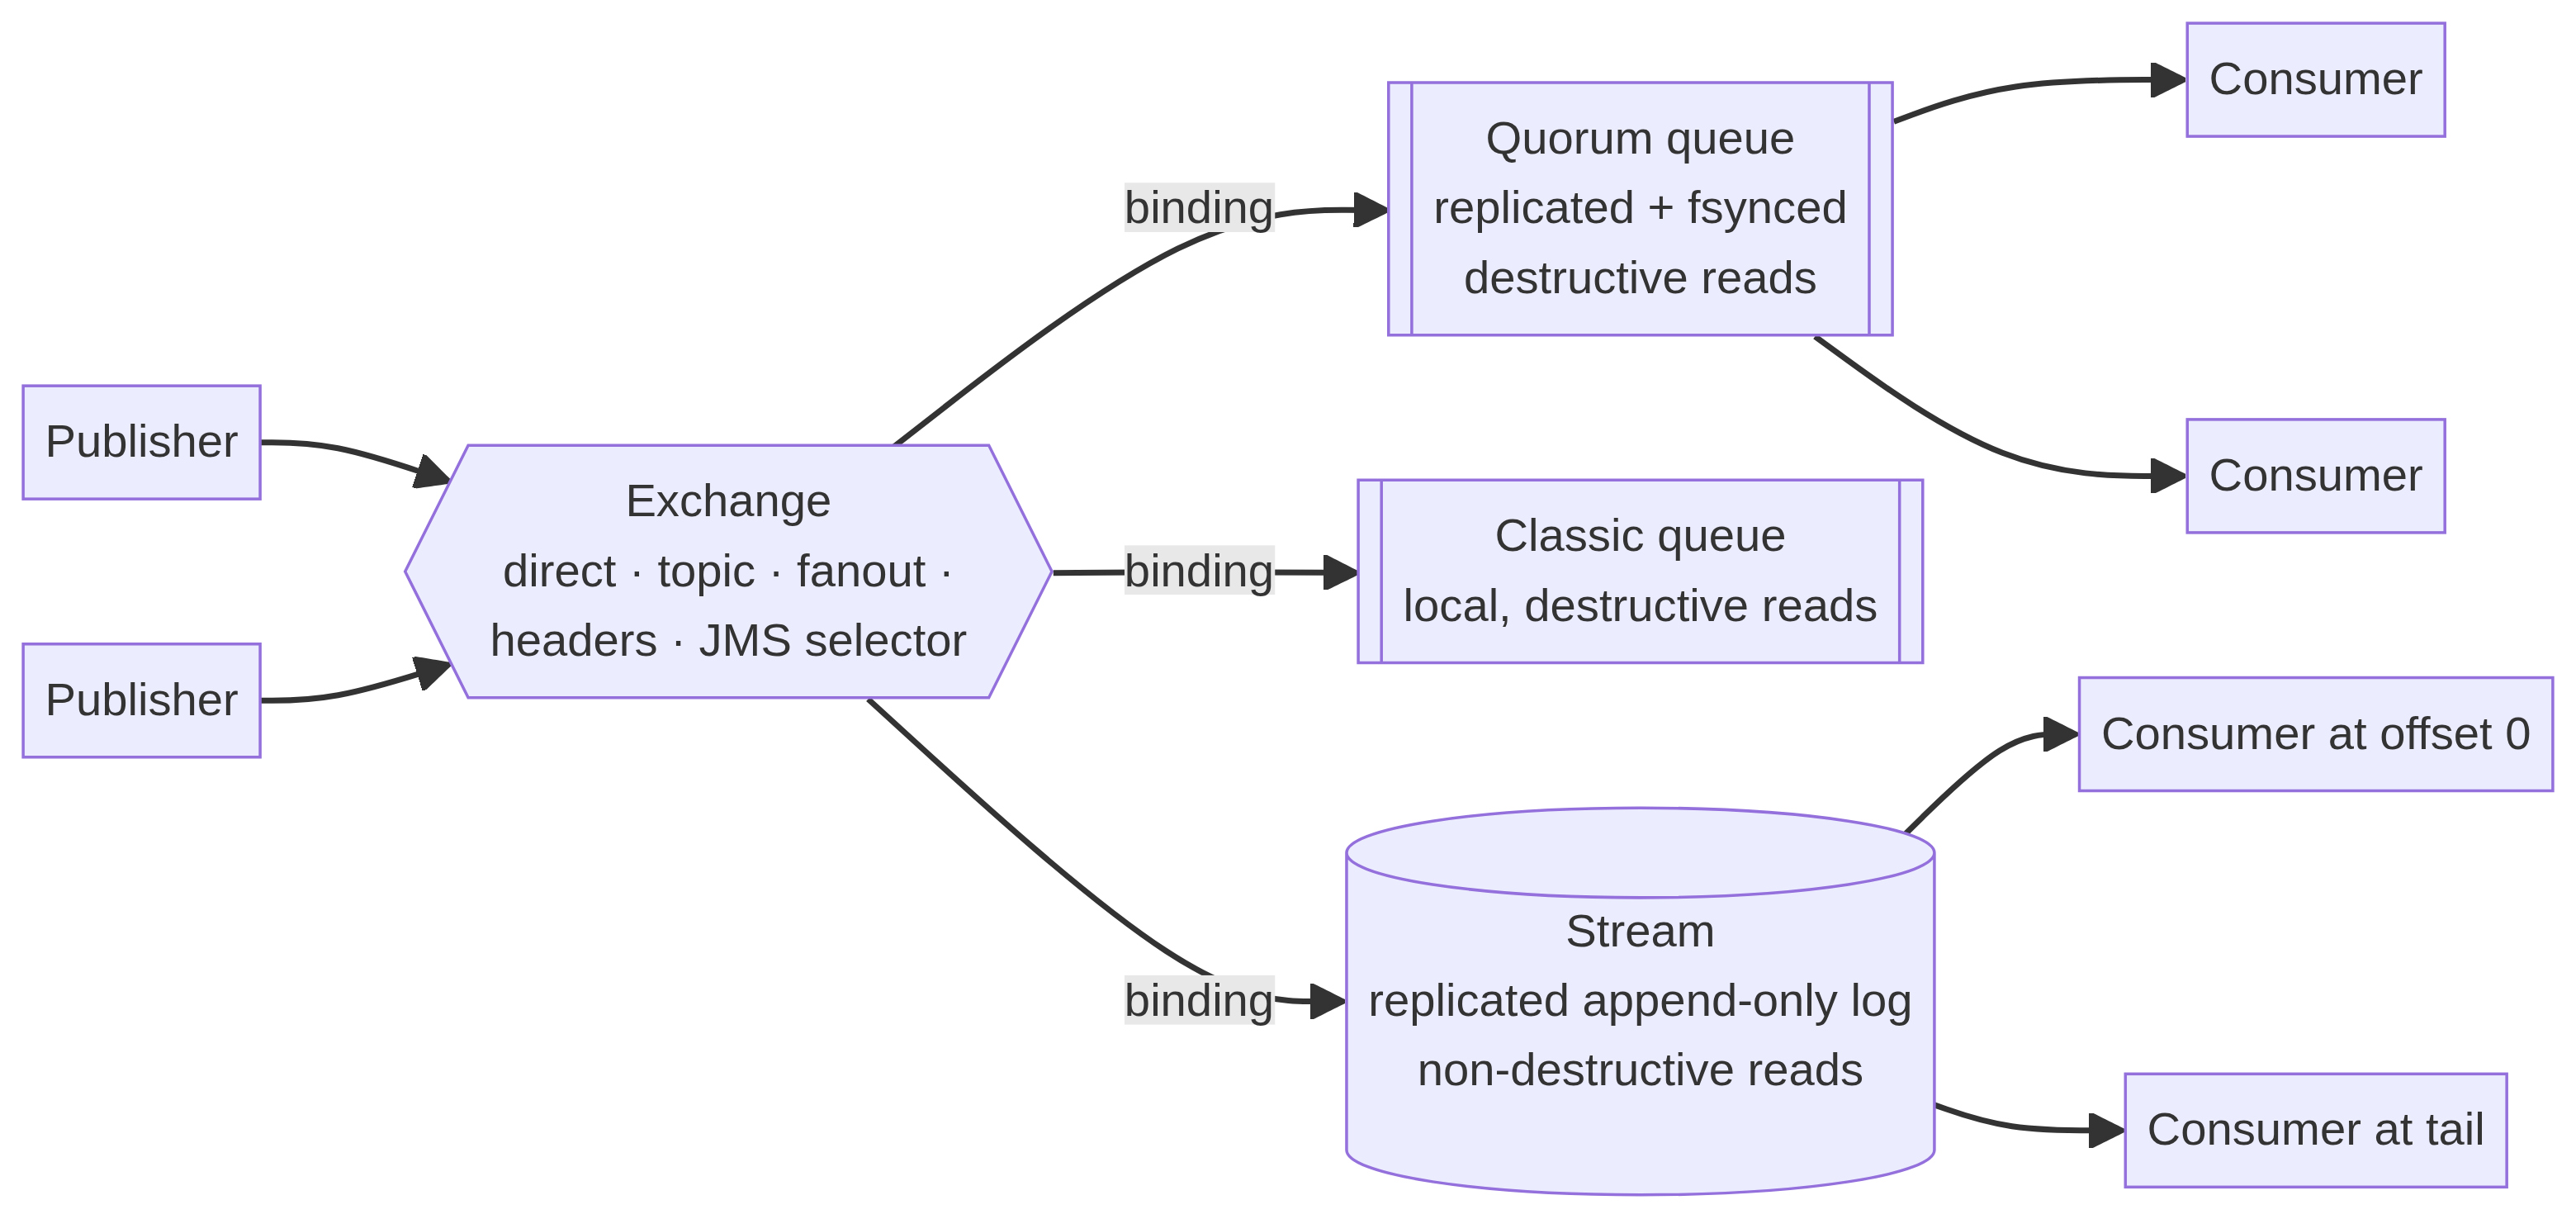
Sơ đồ gốc từ bài RabbitMQ: publisher → exchange → queue/stream → consumer.
| Loại dữ liệu | Cách lưu | Cách đọc | Phù hợp với |
| Quorum queue | Log được Raft replication và fsync trước khi confirm | Destructive: đọc xong và acknowledge thì message được loại khỏi backlog | Phân phối công việc cần an toàn dữ liệu và high availability |
| Classic queue | Lưu cục bộ theo từng message | Destructive | Queue một node, nhiều biến động, dữ liệu tạm thời |
| Stream | Replicated append-only log | Non-destructive: nhiều consumer có thể đọc lại | Fan-out, replay, backlog lớn, throughput cao |
| JMS queue | Raft replication và fsync trước confirm | Destructive hoặc non-destructive | Ứng dụng JMS cần selector hoặc queue browser |
| MQTT QoS 0 queue | Không lưu bền | Destructive | Fan-out độ trễ thấp, fire-and-forget |
Một cluster RabbitMQ có thể chạy đồng thời các loại trên. Đây là khác biệt quan trọng: bạn không phải ép mọi use case vào một kiểu lưu trữ duy nhất.
3. RabbitMQ Streams gần Kafka ở điểm nào?
Một super stream tương đối giống Kafka topic, còn mỗi stream bên trong tương đối giống một Kafka partition. Tuy nhiên, ánh xạ này không hoàn toàn tương đương. Stream của RabbitMQ là một object có tên riêng và có thể tạo, bind hoặc consume độc lập. Kafka partition là thành phần phụ thuộc vào topic.
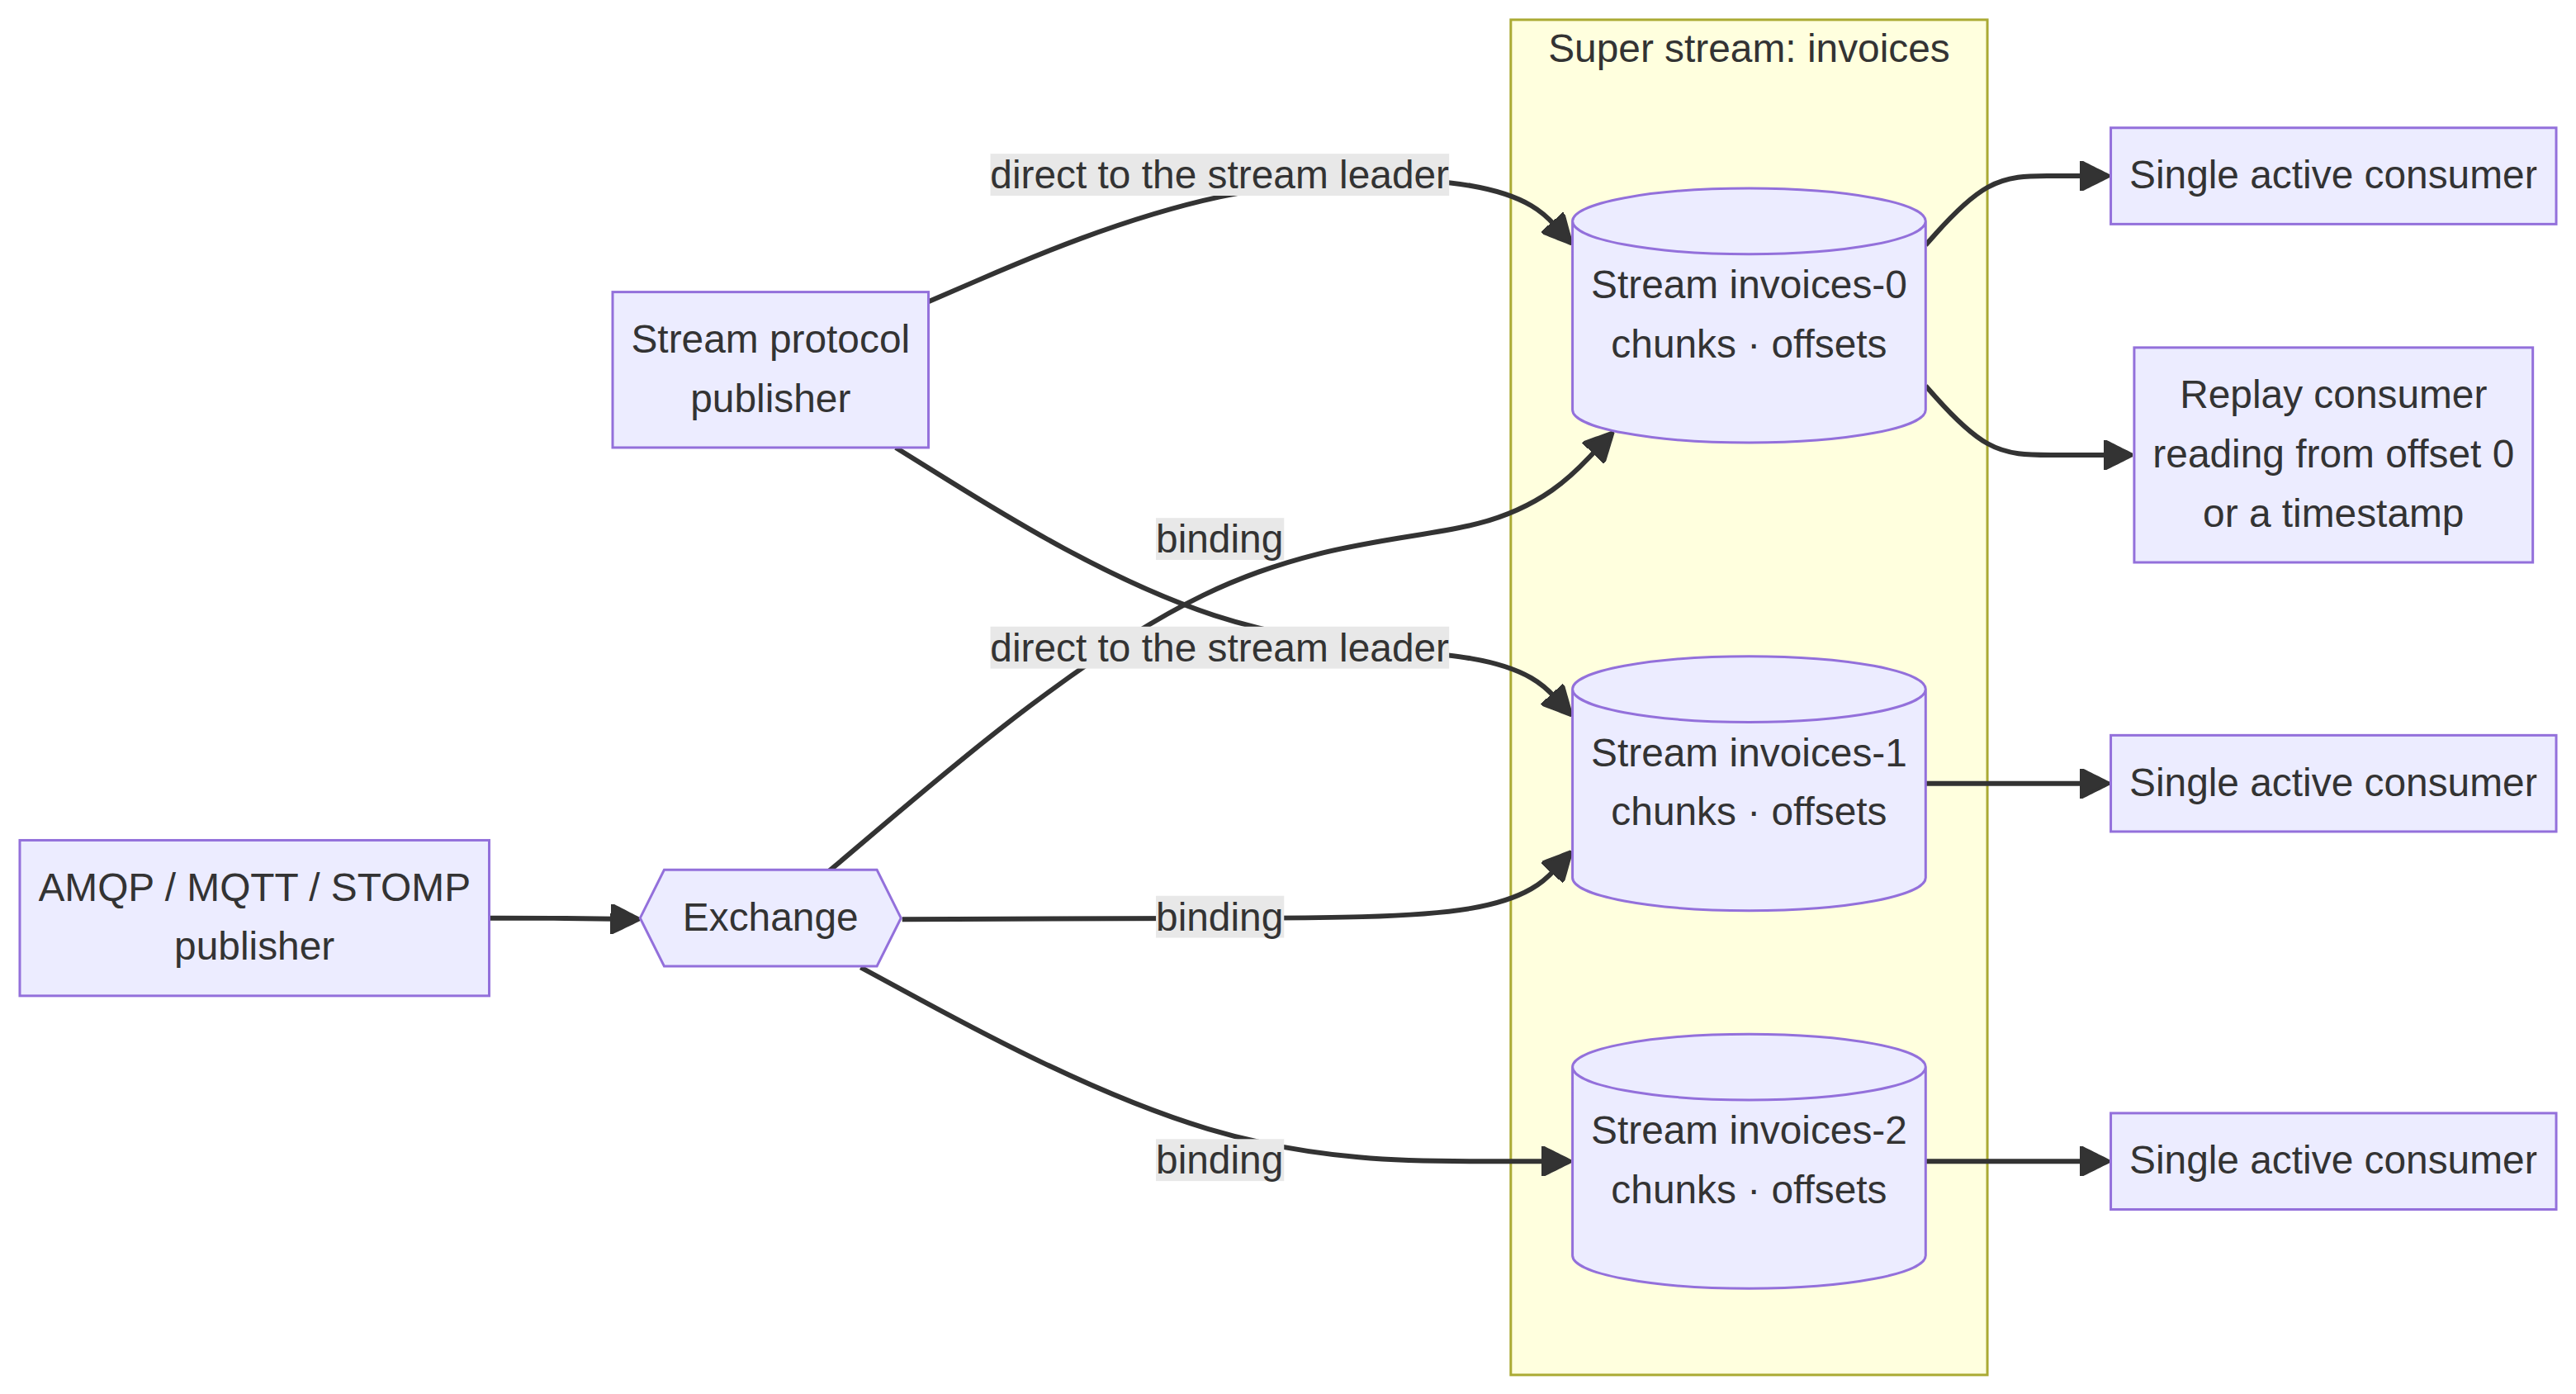
Sơ đồ gốc từ bài RabbitMQ: super stream gồm nhiều stream, hỗ trợ cả ghi trực tiếp và ghi qua exchange.
Publisher dùng RabbitMQ Stream Protocol có thể ghi thẳng tới stream leader, tương tự Kafka producer ghi tới partition leader. Nhưng RabbitMQ vẫn cho phép publisher dùng AMQP, MQTT hoặc STOMP gửi qua exchange vào chính stream đó. Kafka không có đường đi tương đương: muốn ghi vào Kafka topic, producer phải nói Kafka protocol.
| Kafka | RabbitMQ | Ý nghĩa |
| Topic | Super stream | Super stream là nhóm logic của các stream độc lập |
| Partition | Stream | Stream là object có danh tính riêng |
| Offset | Offset | Cả hai đều theo dõi vị trí đọc phía broker |
| Record batch | Chunk | Đều gom nhiều message để giảm chi phí xử lý |
| Consumer group | Single active consumer trên mỗi partition | Đều hỗ trợ đọc song song theo partition và giữ thứ tự |
| Producer tới partition leader | Stream client tới stream leader | Cùng hình dạng hiệu năng; RabbitMQ còn hỗ trợ ghi qua exchange |
4. Kafka tổ chức dữ liệu như thế nào?
Kafka topic được chia thành các partition. Mỗi partition là chuỗi message bất biến, có thứ tự, được ghi nối tiếp trên đĩa. Mỗi message nhận một offset tăng dần. Các message có cùng key thường đi vào cùng partition; đây là cơ chế để giữ thứ tự cho một nhóm sự kiện liên quan.
Producer quyết định partition, thường bằng cách băm key. Broker không đọc nội dung để định tuyến. Với consumer group thông thường, mỗi partition chỉ được một consumer trong group xử lý tại một thời điểm, nên mức song song bị giới hạn bởi số partition. Share group nới giới hạn này bằng cách giao từng message cho nhiều consumer.
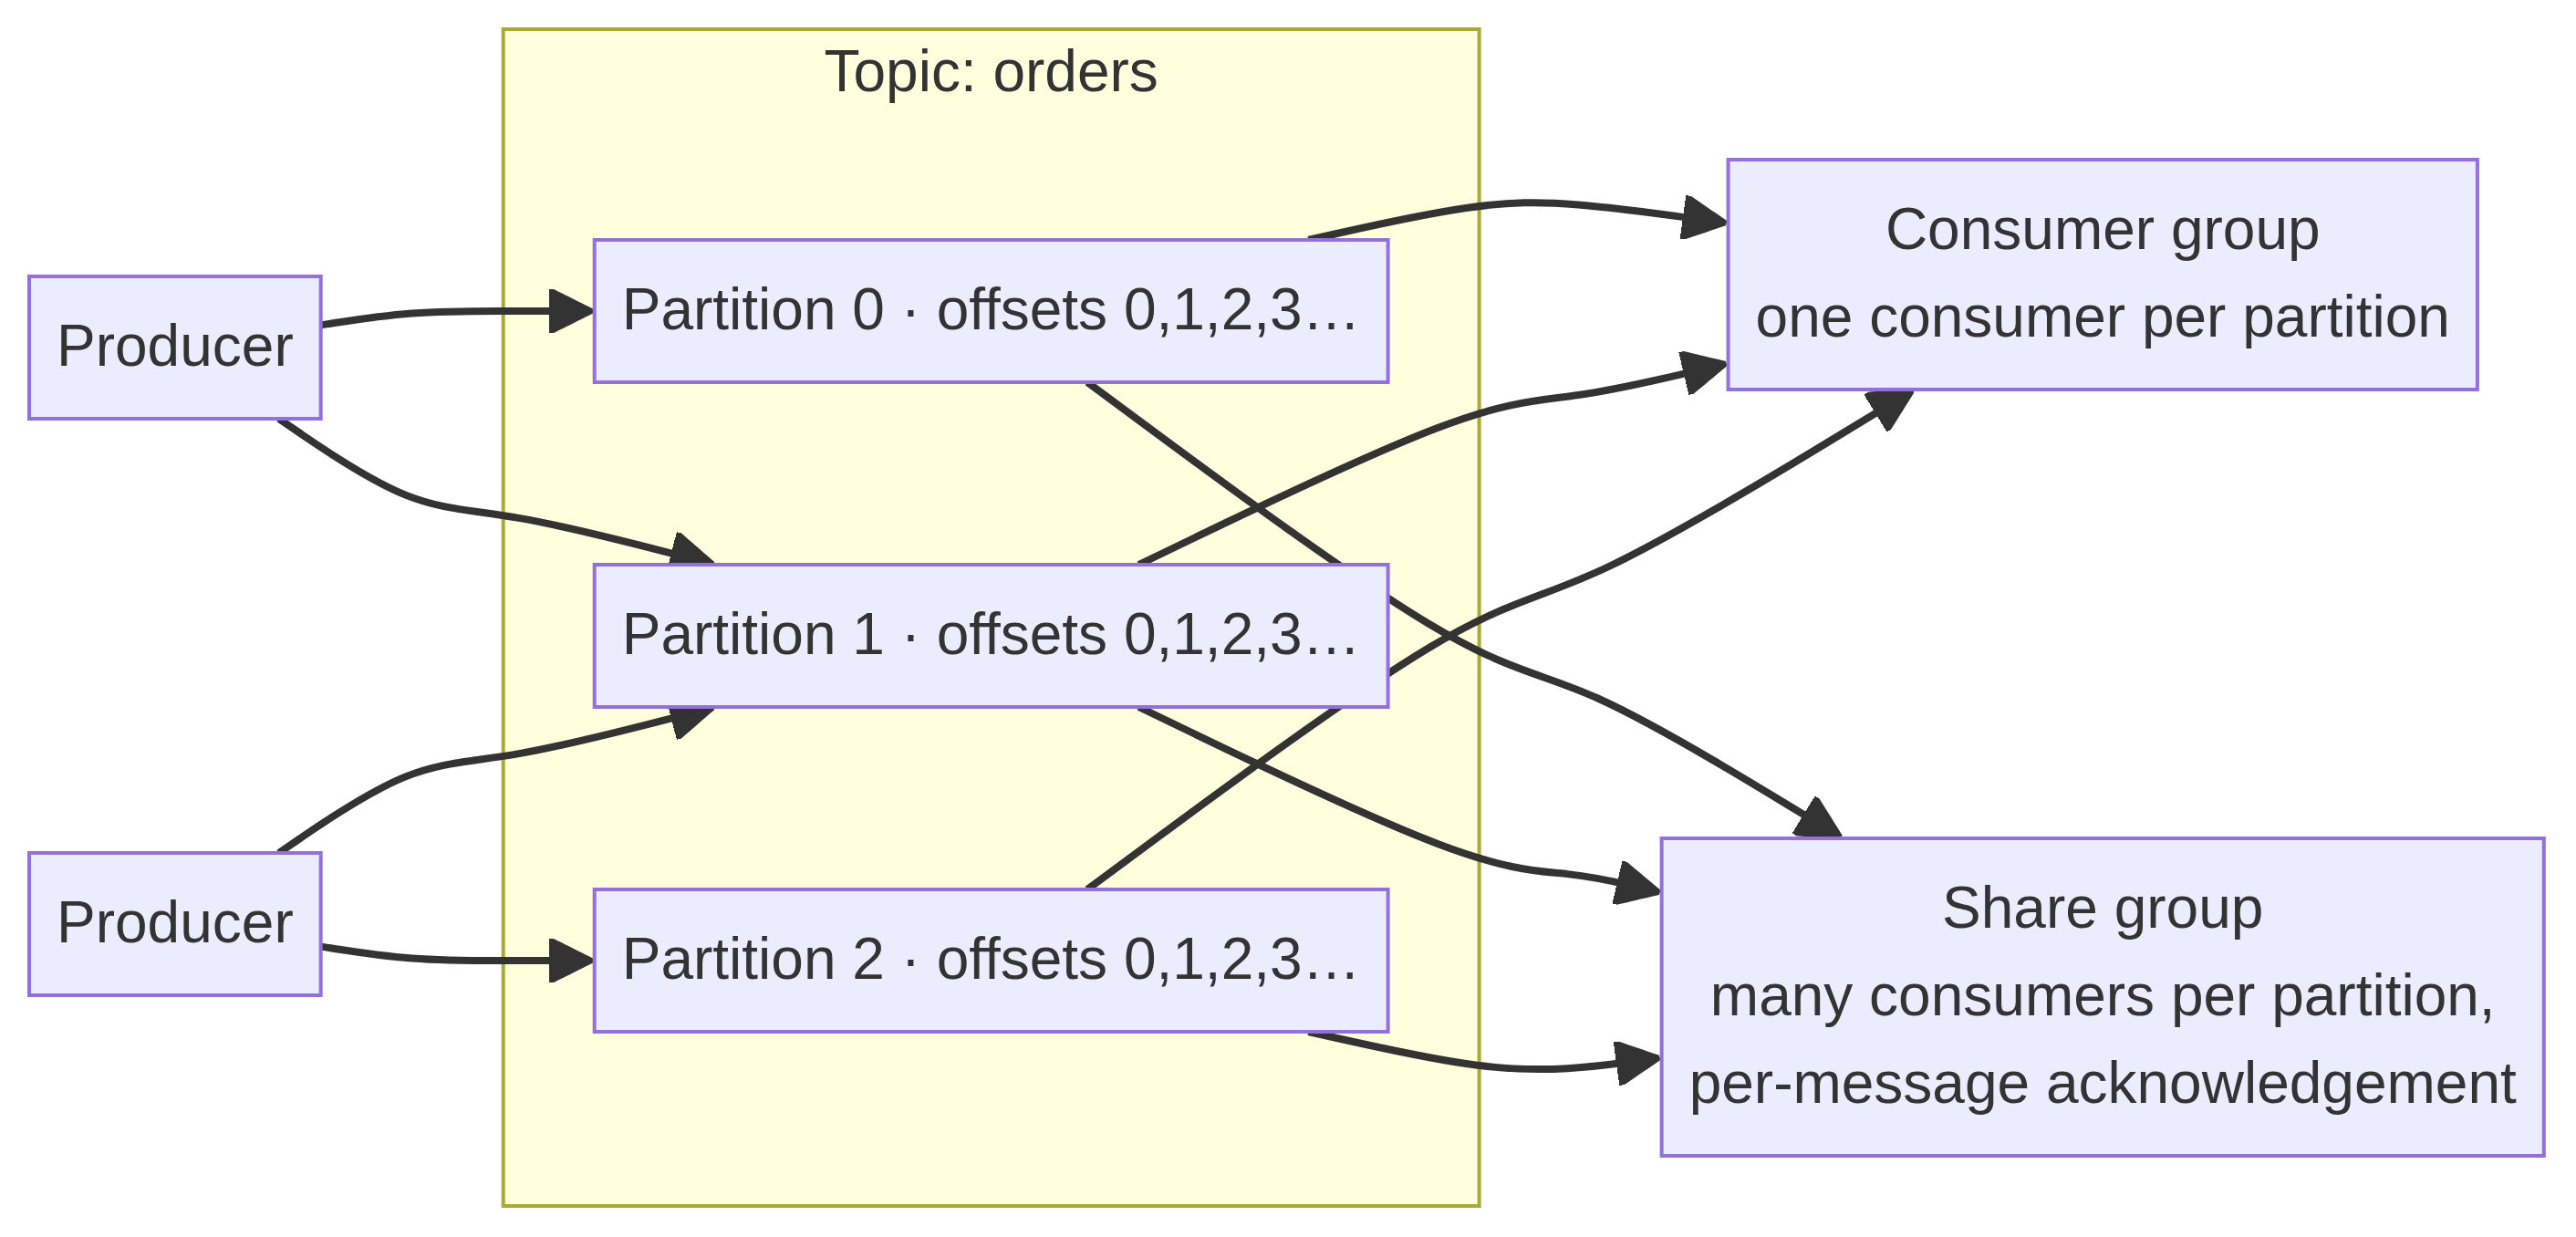
Sơ đồ gốc từ bài RabbitMQ: Kafka topic, partition, consumer group và share group.
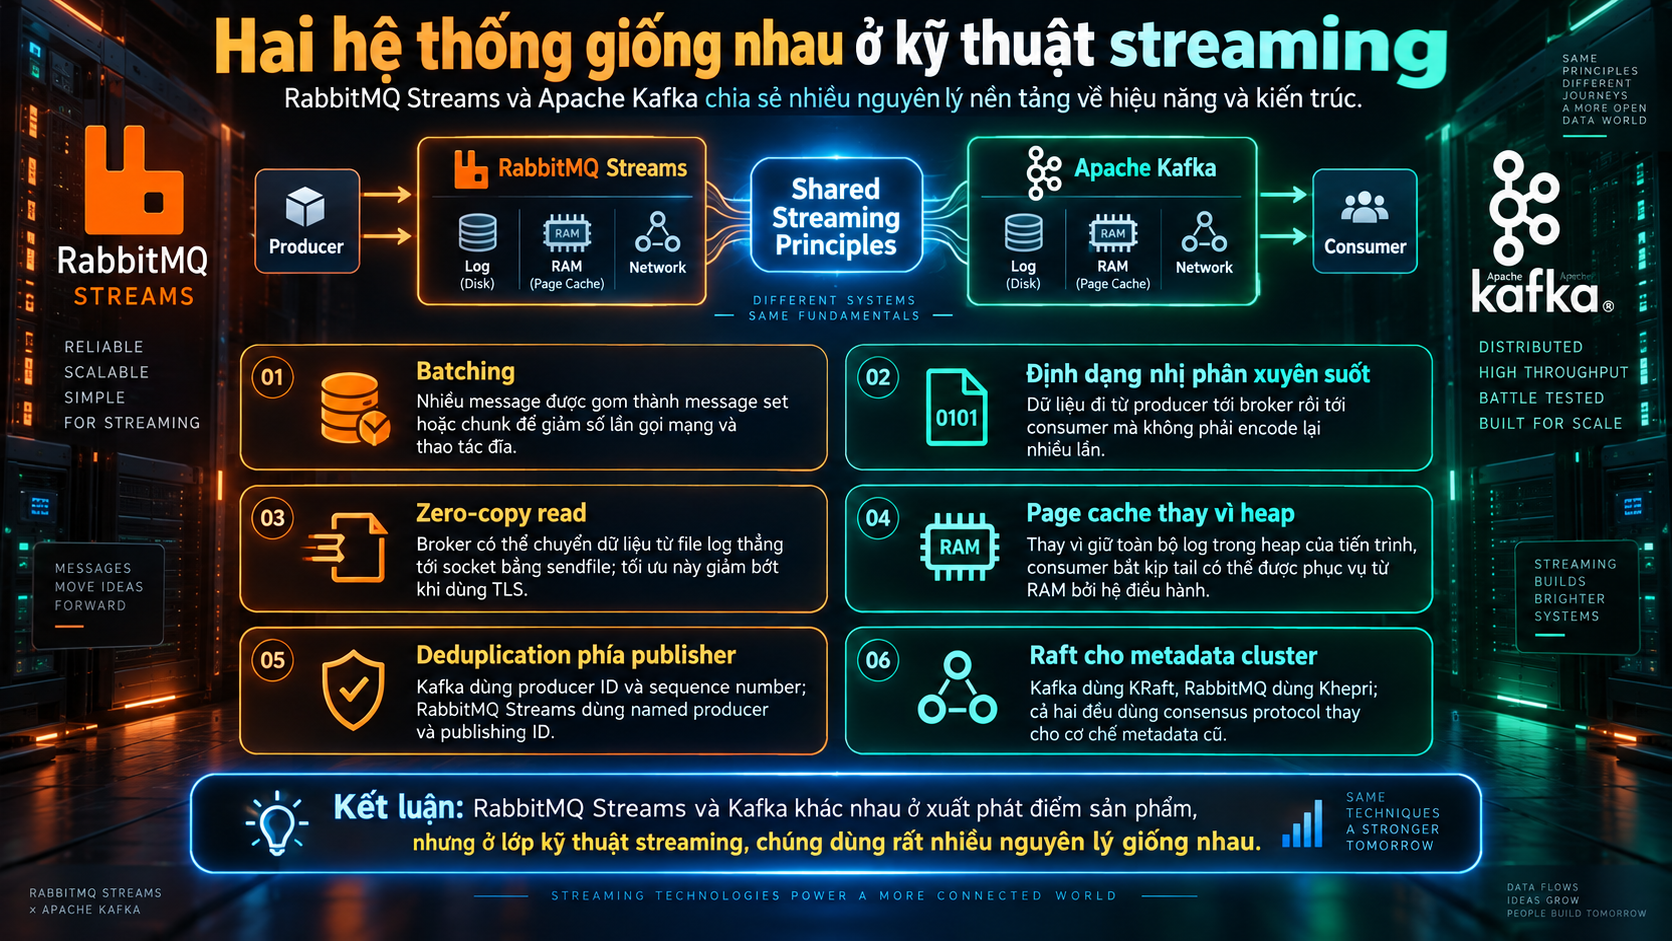
5. Hai hệ thống giống nhau ở kỹ thuật streaming
Nếu bạn đã hiểu vì sao Kafka có throughput cao, bạn sẽ nhận ra RabbitMQ Streams dùng nhiều nguyên lý tương tự:
- Batching: nhiều message được gom thành message set hoặc chunk để giảm số lần gọi mạng và thao tác đĩa.
- Một định dạng nhị phân xuyên suốt: dữ liệu đi từ producer tới broker, rồi tới consumer mà không phải encode lại nhiều lần.
- Zero-copy read: broker có thể chuyển vùng dữ liệu từ file log thẳng tới socket bằng sendfile, dù tối ưu này không còn đầy đủ khi dùng TLS.
- Page cache thay vì giữ toàn bộ log trong heap của tiến trình. Consumer bắt kịp tail có thể được phục vụ từ RAM bởi hệ điều hành.
- Deduplication phía publisher: producer ID và sequence number của Kafka tương tự named producer và publishing ID của RabbitMQ Streams.
- Raft cho metadata cluster: Kafka dùng KRaft, còn RabbitMQ dùng Khepri. Cả hai đều dùng consensus protocol thay cho cơ chế metadata cũ.
6. Khác biệt cốt lõi: queue xử lý từng message
Trong Kafka, message trước hết là một vị trí trong log chung. Trong RabbitMQ, message là một đơn vị công việc độc lập. RabbitMQ không cần đọc payload; payload vẫn là các byte opaque. Broker chỉ đọc envelope như header, annotation và property để có thể định tuyến, lọc, áp TTL, priority hoặc scheduled delivery.
Vì message RabbitMQ độc lập, một message có thể được giữ lại, retry, đổi tuyến, dead-letter hoặc xóa mà không buộc các message bên cạnh phải chờ. Trong log Kafka, vị trí của message gắn với các message xung quanh; tiến độ của share group chỉ tiến lên khi các message trước đó đạt trạng thái kết thúc.
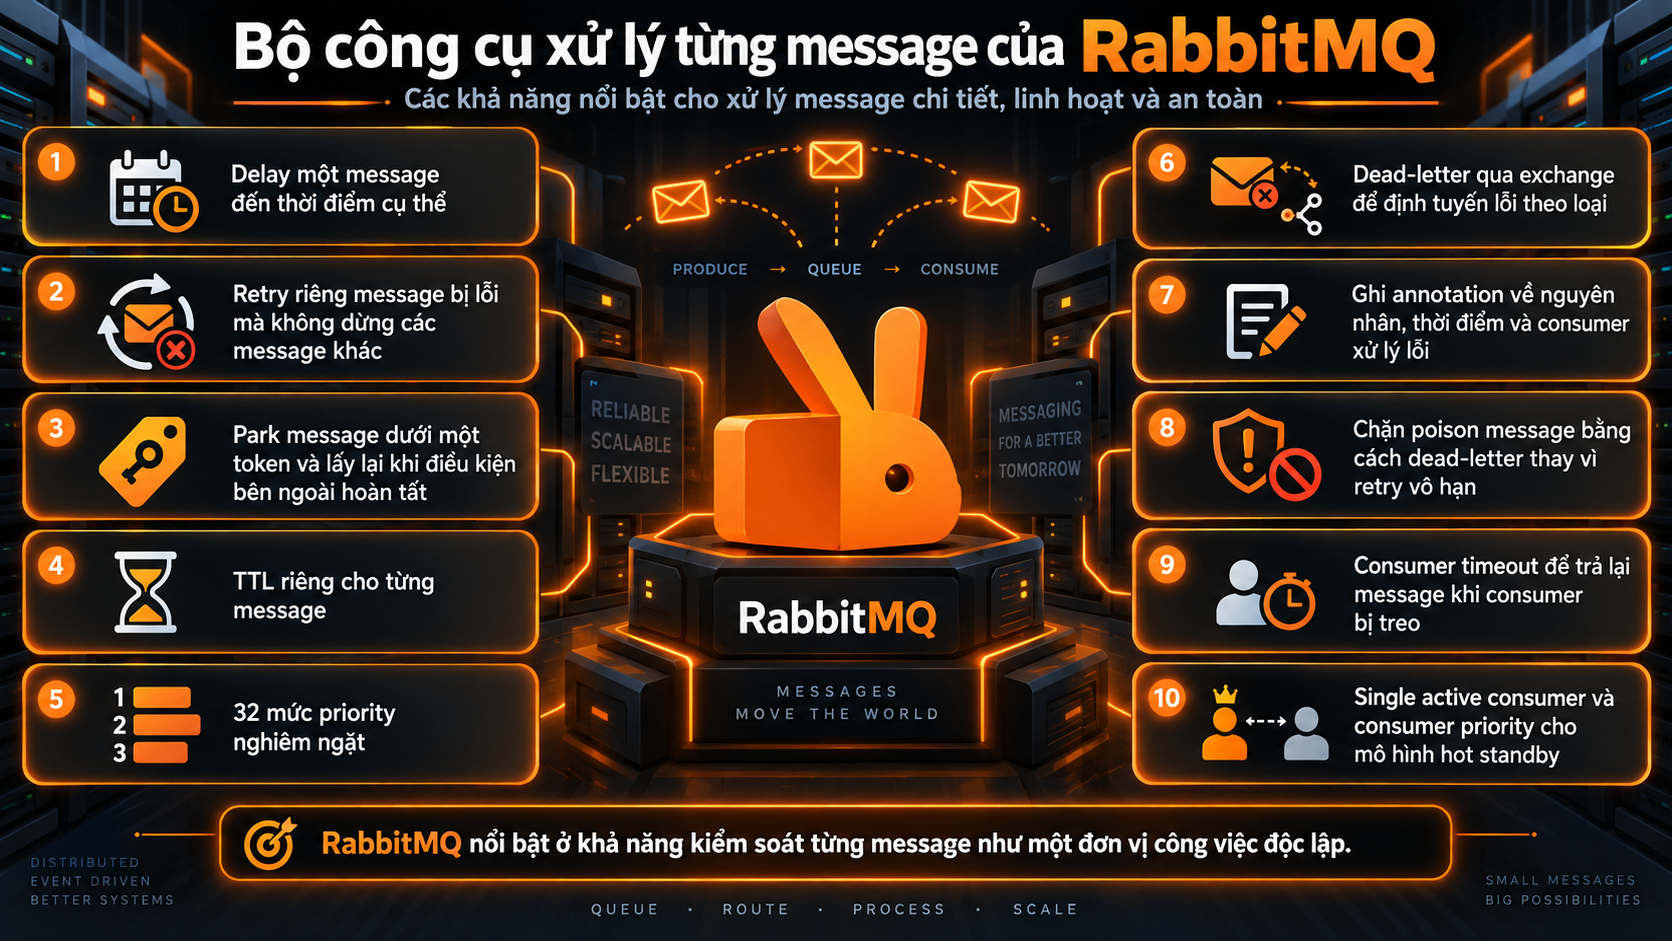
Bộ công cụ xử lý từng message của RabbitMQ
- Delay một message đến thời điểm cụ thể.
- Retry riêng message bị lỗi mà không dừng các message khác.
- Park message dưới một token và lấy lại khi điều kiện bên ngoài hoàn tất.
- TTL riêng cho từng message.
- 32 mức priority nghiêm ngặt.
- Dead-letter qua exchange để định tuyến lỗi theo loại.
- Ghi annotation về nguyên nhân, thời điểm và consumer xử lý lỗi.
- Chặn poison message bằng cách dead-letter thay vì retry vô hạn.
- Consumer timeout để trả lại message khi consumer bị treo.
- Single active consumer và consumer priority cho mô hình hot standby.
7. Share groups của Kafka giải quyết được gì?
Share groups là một cải tiến đáng kể. Chúng hỗ trợ nhiều consumer trên một partition, acknowledge từng message, đếm số lần delivery, giới hạn retry, khóa acquisition trong thời gian giới hạn và các trạng thái release, reject, renew.
Tuy nhiên, share group không thay đổi lớp lưu trữ bên dưới. Acknowledge không xóa message khỏi partition; message vẫn tồn tại cho tới khi retention loại bỏ. Kafka cũng không có sẵn TTL, priority, delay, deferral, dead-letter routing hoặc bộ lọc phía broker cho chế độ này.
Head-of-line blocking được giảm nhưng không biến mất. Nếu một message cũ chưa hoàn tất, start offset vẫn bị ghim. Khi khoảng cửa sổ đạt giới hạn, partition có thể ngừng fetch thêm message. Trong RabbitMQ, một message chưa acknowledge không ngăn các consumer khác tiếp tục nhận message; message có vấn đề có thể được delay, dead-letter hoặc park khỏi đường giao việc.
8. Durability: “đã acknowledge” thực sự có nghĩa gì?
Độ bền không phải một thuộc tính tuyệt đối. Nó là tập hợp các biện pháp giảm rủi ro: ghi đĩa, replication sang máy khác, tách vùng lỗi và backup. Cấu hình mặc định của hai hệ thống tạo ra khác biệt đáng chú ý.
| Mô hình lưu trữ | Replication | Fsync trước confirm | Có chịu được mất điện toàn site? | Standby liên site |
| Kafka topic — streaming và queue semantics | Có | Không, mặc định không khuyến nghị | Không chắc; message đã confirm nhưng chưa fsync có thể mất | MirrorMaker 2 |
| RabbitMQ stream | Có | Không; trade-off giống Kafka | Không; cùng mức phơi nhiễm | Warm Standby Replication |
| RabbitMQ quorum queue | Có | Có | Có, trong giới hạn mô hình quorum | Warm Standby Replication |
Kafka mặc định dựa chủ yếu vào replication và page cache. Khi producer nhận confirm với acks=all, message đã nằm trong page cache của các replica đang đồng bộ, nhưng chưa nhất thiết có mặt trên đĩa vật lý. Nếu toàn bộ các replica trong cùng trung tâm dữ liệu mất điện đồng thời, message đã acknowledge nhưng chưa fsync có thể bị mất.
Quorum queue của RabbitMQ chỉ confirm sau khi đa số thành viên Raft đã ghi và flush message xuống đĩa. Vì vậy, bạn có thể chọn RabbitMQ stream khi cần trade-off giống Kafka, hoặc chọn quorum queue khi ưu tiên durability mạnh cho đơn hàng, thanh toán và job không được đánh mất.
9. Routing và filtering: quyết định nằm ở đâu?
Kafka đặt routing ở producer. Producer chọn topic hoặc partition; consumer thường subscribe toàn topic. Nếu một consumer chỉ quan tâm một phần dữ liệu, nó phải tự lọc, tạo topic dẫn xuất hoặc chia dữ liệu thành nhiều topic. Điều này có thể dẫn tới topic sprawl, metadata nhiều hơn và chi phí replication cao hơn.
RabbitMQ đặt routing ở broker. Consumer có thể tạo binding khi chạy, không cần redeploy producer. Exchange hỗ trợ direct, topic, fanout, headers, consistent-hash và các kiểu mở rộng khác. Với stream, RabbitMQ còn hỗ trợ Bloom filter để bỏ qua cả chunk không phù hợp và AMQP filter expression để lọc theo property.
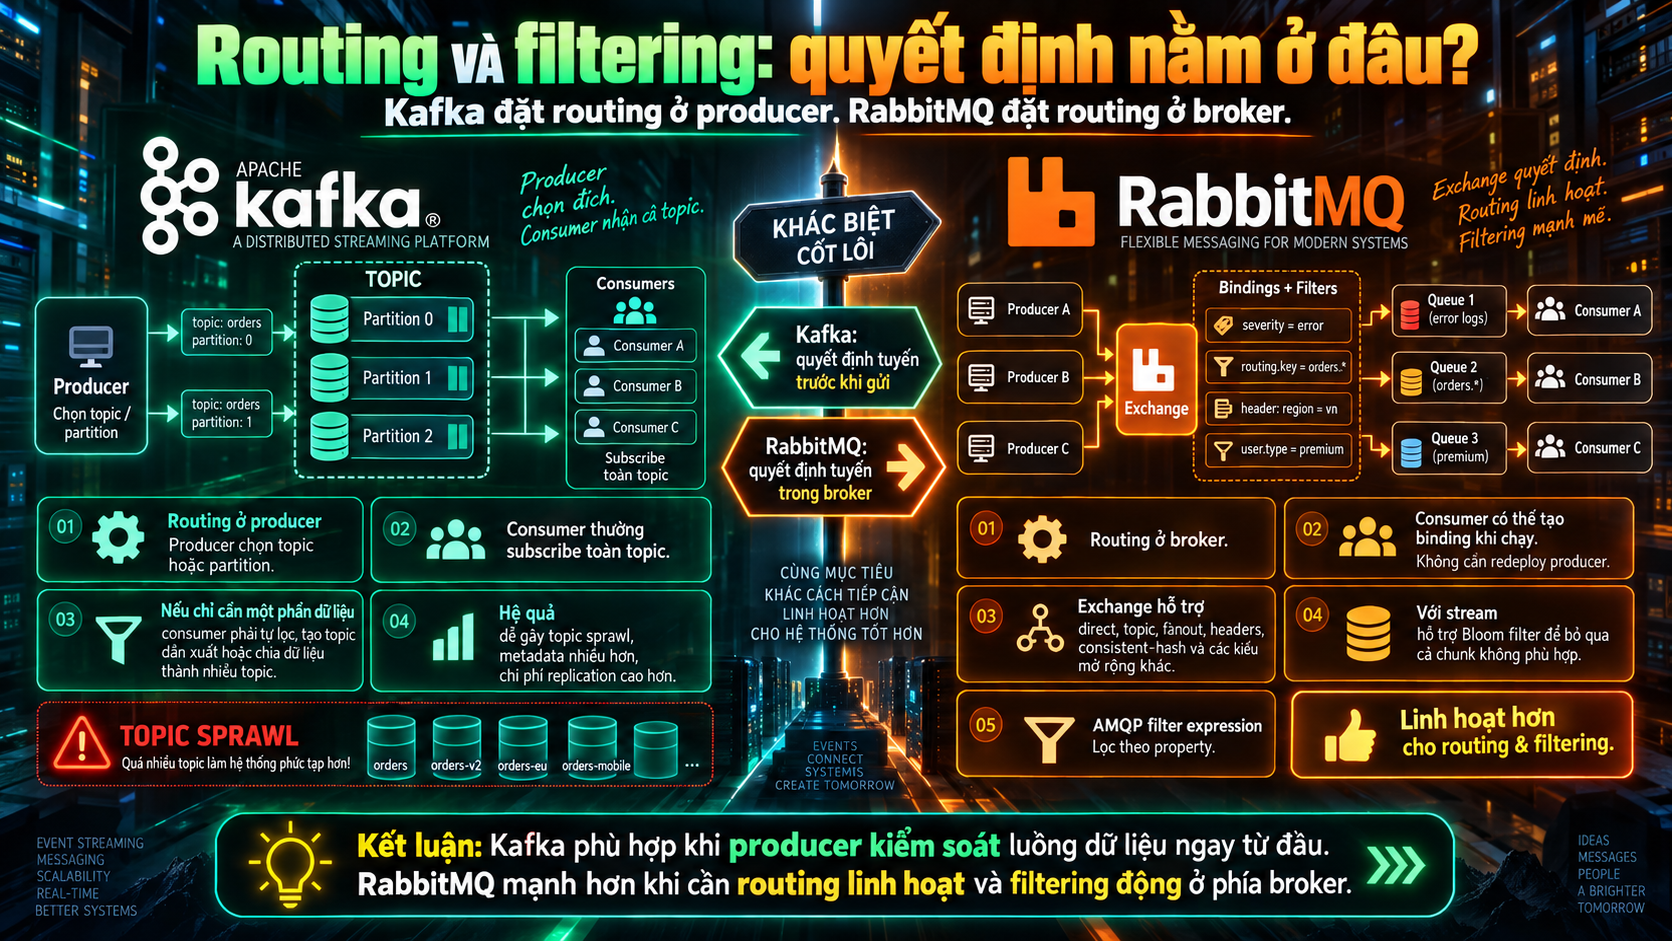
Ví dụ: consumer muốn nhận mọi sự kiện orders.#
Trong RabbitMQ, consumer chỉ cần bind vào topic exchange bằng pattern orders.#. Producer không cần biết consumer nào đang tồn tại. Trong Kafka, các lựa chọn thường là chia thành nhiều topic và subscribe theo pattern, nhận toàn bộ message rồi lọc ở consumer, hoặc triển khai thêm stream-processing job để tạo topic dẫn xuất. Mỗi cách đều tăng chi phí vận hành hoặc lưu trữ.
10. Protocol, vận hành và bảo mật
Kafka có một wire protocol duy nhất, được triển khai rộng rãi nhưng không phải một tiêu chuẩn độc lập chính thức. RabbitMQ xem multi-protocol là một tính năng: cùng một broker có thể nhận AMQP 1.0, AMQP 0-9-1, MQTT, STOMP và RabbitMQ Stream Protocol. Trong hệ thống IoT, message có thể đi vào bằng MQTT, được backend đọc qua AMQP 1.0 và được analytics đọc lại bằng Stream Protocol.
| Khía cạnh | RabbitMQ | Apache Kafka |
| Protocol | AMQP 1.0, AMQP 0-9-1, MQTT, STOMP, Stream Protocol | Kafka protocol |
| Tenant isolation | Virtual host là namespace thực với exchange, queue, quyền và giới hạn riêng | Tên topic + ACL prefix + quota |
| Transport security | TLS cho mọi protocol và kết nối liên node | TLS cho client và inter-broker listener |
| Authentication | SASL, mTLS, x.509, LDAP, OAuth/OIDC và backend mở rộng | SASL, Kerberos, PLAIN, SCRAM, OAuthBearer, mTLS |
| Monitoring | Prometheus endpoint và dashboard Grafana có sẵn | JMX; thường cần thêm JMX exporter để đưa vào Prometheus |
Cả hai đều là hệ thống enterprise-grade. Khác biệt thực tế nằm ở mức độ tích hợp sẵn và cách cô lập tenant. RabbitMQ có management UI, HTTP API, Prometheus endpoint và virtual host; Kafka thường cần thêm các thành phần hoặc quy ước vận hành để đạt trải nghiệm tương đương.
11. Chọn RabbitMQ hay Kafka?
| Nếu yêu cầu chính là… | Ưu tiên cân nhắc | Lý do |
| Retry, delay, TTL, priority, dead-letter theo từng message | RabbitMQ | Broker có sẵn semantics của từng đơn vị công việc |
| Định tuyến động, fan-out có chọn lọc | RabbitMQ | Exchange, binding và filter ở broker |
| Kết nối IoT, browser, JMS và backend trên một broker | RabbitMQ | Nhiều protocol và client tích hợp |
| Quorum queue cần fsync trước confirm | RabbitMQ | Durability mạnh theo từng destination |
| Replay hàng terabyte lịch sử | Kafka hoặc RabbitMQ Streams | Cả hai có log; đánh giá theo retention, tooling và hệ sinh thái |
| Log compaction | Kafka | Đây là năng lực Kafka làm tốt và RabbitMQ không có tương đương trực tiếp |
| Tiered storage | Kafka | Tính năng native phù hợp lưu trữ lịch sử dài hạn |
| Xử lý stream bằng thư viện Kafka Streams | Kafka | Hệ sinh thái và thư viện là lý do chính để chọn Kafka |
Không nên chọn dựa trên benchmark throughput đơn lẻ. Hãy chọn theo semantics mà ứng dụng cần: dữ liệu có phải một chuỗi lịch sử cần replay, hay là các công việc độc lập cần retry, delay, routing và acknowledgement? Sau đó mới kiểm tra throughput, latency, chi phí vận hành, kỹ năng đội ngũ và yêu cầu disaster recovery.
Kết luận
Kafka là nền tảng event streaming được thiết kế rất tốt và vẫn có những bài toán phù hợp hơn bất kỳ giải pháp messaging nào khác. RabbitMQ Streams đã thu hẹp đáng kể khoảng cách ở phía log: batching, zero-copy read, page cache, direct-to-leader publishing và deduplication đều có mặt. Ở phía queue, RabbitMQ vẫn có lợi thế rõ ràng vì xử lý message độc lập, định tuyến ở broker và cung cấp bộ công cụ vận hành từng message.
Cách tiếp cận thực dụng là bắt đầu với RabbitMQ nếu hệ thống cần cả messaging, queueing, routing và streaming trong một broker. Bổ sung Kafka khi xuất hiện yêu cầu đặc thù như log compaction, tiered storage hoặc Kafka Streams. Một hệ thống duy nhất thường rẻ và đơn giản hơn hai hệ thống, miễn là nó đáp ứng đúng semantics của workload.
Ghi chú nguồn và tài liệu tham khảo
Bài viết này là bản viết lại bằng tiếng Việt nhằm giúp người đọc dễ tiếp cận hơn. Các sơ đồ được lấy từ mã nguồn Mermaid chính thức của bài gốc và render lại thành ảnh để chèn vào DOCX. Nội dung kỹ thuật được diễn giải lại, không phải bản dịch từng câu và không thay thế tài liệu vận hành chính thức.
[1] RabbitMQ, “RabbitMQ vs. Apache Kafka”, phiên bản 4.3: https://www.rabbitmq.com/docs/compare/kafka
[2] Mã nguồn bài viết và sơ đồ Mermaid: https://github.com/rabbitmq/rabbitmq-website/blob/main/docs/compare/kafka.md
[3] Apache Kafka, “Design”: https://kafka.apache.org/43/design/design/
[4] Apache Kafka, “KRaft”: https://kafka.apache.org/43/operations/kraft/
[5] RabbitMQ, “Streams”: https://www.rabbitmq.com/docs/streams
[6] Apache Kafka KIP-932, “Queues for Kafka”: https://cwiki.apache.org/confluence/x/4hA0Dw
Vui lòng đăng nhập để bình luận.